Ljetna poslastica: dvadeset i jedan (“židovski”) matematički zadatak

Najprije mala digresija, naime, zašto sam napisao dvadeset jedan umjesto 21? Zato što ovo drugo nije u duhu jezika. U kontekstu formula je naravno drugačije, ali u običnom tekstu nije; pokušajte zamisliti npr. Šenou, Krležu ili nekog pjesnika da ima znamenke u rečenici. Ružno je! Kao što bi rekao Goran Bare: “Tko razumije, razumije. Tko ne razumije, neće nikad ni razumjeti!” (Ako koga zanima, to je rekao na 0:45 na ovom koncertu.)

Jučer sam naletio na zanimljiv članak sa zadatcima s prijamnih ispita moskovskog matematičkog fakulteta. Članak se zove Jewish Problems jer je riječ o malo težim zadatcima koje su na usmenom ispitu postavljali židovskim kandidatima koje očito nisu naročito voljeli:

“Among problems that were used by the department to blackball unwanted candidate students, these problems are distinguished by having a simple solution that is difficult to find. Using problems with a simple solution protected the administration from extra complaints and appeals.”

Malo sam škicnuo rješenja i čini se da nisu sva baš tako kratka i jednostavna, ali izgleda da su zadatci odlični. Ono što je osobito dobro jest da prije poglavlja Solutions postoji poglavlje Ideas koji sadrži hintove za sve zadatke. To je odlična praksa! Kad sam se ja natjecao, u materijalima toga uglavnom nije bilo. Možda je sad drugačije, ali ako nije, svakako treba biti.

I za kraj, što drugo mogu nego preporučiti knjigu AHA! Matije Bašića! Pod uvjetom da se na ovoj vrućini ne razlijemo po kaučima i mozak nam ne postane toplo varivo.

Jezik i umjetna inteligencija

U jednom od prethodnih postova napisao sam da se umjetna inteligencija, točnije neuronska mreža, može svesti na matematičku formulu. Tehnički gledano to je točno, ali i varljivo jer daje krivu intuiciju: ono što zamišljamo kad čujemo za matematičku formulu, iako “znamo” da je “jako velika i složena”, nije neuronska mreža. Slična pogrešna intuicija koja banalizira moć softvera nalazi se u pozadini Chinese Room argumenta Johna Searlea koji sam spomenuo u istom postu. Tako nam je čudno što svijest, inteligencija ili slobodna volja mogu nastati iz interakcije čestica ili formula/algoritama. Naprosto nemamo osjećaj za pojave koji izviru iz low-level fenomena ako se usredotočimo samo na tu razinu. Andrew Steane u knjizi Science and Humanity piše:

“When we say that a monkey is a collection of atoms and molecules, we are right, but that does not logically imply that we understand monkey behaviour, and furthermore, neither does it imply that our current best understanding of molecules is sufficient to support a correct model of monkey behaviour. In fact, it is the monkey behaviour itself that will teach us what monkey-shaped molecules can do. In this way, the monkey fills our understanding of what molecules are, at the same time as it fills out understanding of what monkeys are.”

Iz istog razloga, filozofske probleme umjetne inteligencije valja rješavati u suprotnom smjeru od onog Searlovog i intuitivnog. Umjesto da iz sastavnih dijelova (umjetnih neurona koji se mogu opisati formulama) zaključujemo za što bi AI mogao ili ne bi mogao biti sposoban, možemo samo obrnuto: iz njegovog ponašanja zaključiti za što su sposobni umjetni neuroni, prikladno organizirani na odgovarajući način. To je u skladu s našim iskustvom o ljudskom mozgu – tko bi na prvi pogled rekao da nakupina stanica može razmišljati i osjećati? I u skladu je s funkcionalizmom: consciousness is what consciousness does. Drugim riječima: If it looks like a duck, swims like a duck, and quacks like a duck, then it is a duck. Ne postoji suština, postoje samo svojstva.

A svojstva (relacije) su ključ razumijevanja umjetne inteligencije koja zna engleski jezik, dopunjava rečenice i odgovara na pitanja. Ugrubo, svaka riječ u njezinom je umu niz od nekoliko stotina brojeva (vektor) takav da značenjski odnosi među riječima odgovaraju matematičkim odnosima među vektorima koji predstavljaju te riječi. Primjeri takvih relacija su man : boy = woman : girl (ovdje omjer ne treba shvatiti doslovno) ili Paris – France + Italy = Rome ili Scientist – Einstein + Picasso = Painter ili Windows – Microsoft + Google = Android. Za detalje i bolje razumijevanje snažno preporučujem ovaj članak.

Netko bi sada mogao uputiti sljedeći prigovor:

AI zna samo odnose među različitim riječima, ali on ne zna pravo značenje nijedne riječi! On bi možda mogao napisati rječnik, tj. svaku riječ objasniti drugim riječima, ali nijednu od tih riječi on u glavi ne bi pridružio stvarnosti, za razliku od čovjeka.

Odgovor nije intuitivan, a glasi da ni mi (ljudi) ne znamo ništa osim relacija. Ako zamišljamo npr. pojam mlijeko, u našem mozgu ne postoji ništa slično mlijeku: sve što postoji je aktivacija određenih sinaptičkih veza, što nije toliko različito od matematičkih veza u AI. Netko će reći da u našoj svijesti postoji slika mlijeka. Ali ta je slika ponovno samo veza s drugim pojmovima: s bijelom bojom, s tekućinom, sa šalicom ili bocom ili tetrapakom ili što god je naša asocijacija na mlijeko i tako dalje. Ni ti drugi pojmovi u našoj glavi nisu drugo nego niz asocijacija. U konačnici dolazimo do osjetilnih pojmova (boje, zvukovi…) za koje možemo reći da ih izravno poznajemo. Ali i oni su u našem mozgu zapisani na način koji nema veze ni s bojom, ni sa zvukom: to je također reprezentacija, možda ne numerička (vektor) kao u slučaju umjetne inteligencije, ali i dalje u suštini matematička i funkcionalna samo po svojem odnosu s drugim reprezentacijama.

Ovdje je zgodno napomenuti da ni čestice možda nemaju suštinu. Svaki kvark ili elektron, ili koje god čestice / valovi / strune bile fundamentalne u smislu nedjeljivosti, u potpunosti su opisane svojim svojstvima i odgovarajućim brojevima (“what it does”) i vjerojatno nema smisla pitati od čega su napravljene (“what it is”). Iz te perspektive svemir je samo golemi skup matematičkih relacija, a gradivna tvar na najnižoj razini uopće ne postoji. Tako u knjizi Our Mathematical Universe Max Tegmark tvrdi da je stvarnost matematička struktura (i vremenska dimenzija je njezin dio) i da naš svemir postoji jednostavno zato što postoje sve matematičke strukture, same po sebi. To znači da iz istog trivijalnog razloga postoje svi mogući svemiri. Slično tvrdi i filozof David Lewis (doduše iz drugih razloga) u svojoj knjizi On the Plurality of Worlds: sve što je moguće, postoji. Bilo bi zbilja užasno da je to istina, ali to ne znači da nije.

Male tajne velikih brojeva

O nuli sam već pisao u postu I nula je broj. Ondje nisam spomenuo jedno zanimljivo svojstvo nule o kojemu ću sada govoriti, a bez kojeg matematički doživljaj ovog broja ne bi bio potpun.

Poanta nule nije u ništavilu, nego u potencijalu. Recimo, ako imam slobodan dan ili dio godišnjeg odmora s nula obaveza i planova, dakle, ako uopće ne znam kako ću ga provesti, osjećam se izvrsno jer potencijalno dopuštam svemu da se dogodi. John C. Parkin napisao je: “All things manifest from nothing. Leave space, lots of space, in your life.” Toga je bio svjestan i naš poznati matematičar Vladimir Devidé kada je ovako komentirao sljedeću japansku haiku pjesmu:

Koliba u proljeće:
ničega u njoj –
u njoj je sve!

(Sodō, 1642. – 1716.)

“Pročitavši to, bio sam kao ošinut. U proljeće, kad se sve budi, eto prazne kolibe koja upravo time što je prazna omogućava da sve uđe u nju, upravo ga zove. Nema ničega, nikakvih nepotrebnih stvari koje bi to priječile. Svo bujanje proljeća puni praznu kolibu svojim beskrajnim bogatstvom.”

Poanta minimalizma nije u redukciji broja stvari, nego u činjenici da oslobađanjem od suvišnih stvari ostavljamo mjesta za nove stvari. Recimo, jednom sam riješio jednadžbu tako što sam odlučio da je uopće neću riješiti. Neke sam knjige namjeravao pročitati, ali taj sam problem riješio odlukom da ih uopće neću pročitati. Idealno matematičko predavanje bilo bi ono u kojemu se ne bi govorilo o ničemu. Mnoge stvari u životu unaprijed su riješene odlukom da ih neće biti.

U sličnom smjeru ide i sljedeća ideja: možda je bolje kupiti ručni sat nego, recimo, gitaru ili bicikl. Naime, gitaru treba svirati, bicikl treba voziti, a sat radi sam od sebe: on uzima nula vremena i kao takav daje sve vrijeme svijeta! Nastavimo li ovako zaključivati, možda je još bolje kupiti zidnu sliku jer ona traži još manje od sata (ne treba je ni nositi na ruci). Potom, još je bolja neka stvar koju uopće ne možemo kupiti jer s njom ne moramo baš ništa, ni kupiti je ni išta s njom činiti. A najbolja je ona stvar za koju uopće ne znamo da postoji, jer onda ni ne znamo da s njom ne moramo ništa. Eto, to je poanta nule, to je poanta slobode i to je poanta godišnjeg odmora.

Može li računalo misliti?

Trenutačno je vruća tema novi AI model GPT-3 koji odlično razumije jezik i djeluje prilično inteligentno.

Naravno, riječ razumije ovdje nema značenje s kojim će se svi složiti. Pojednostavljeno rečeno, GPT-3 je duboka neuronska mreža, a to nije drugo nego ogromna matematička formula čiji se brojevi namještaju na osnovi milijardi primjera za učenje (tekstovi s Wikipedije i slično). Ugrubo, ona kao ulaz prima rečenicu, a izbacuje njezin nastavak ili odgovor na pitanje. Kao i svaki računalni program, tu bismo formulu teoretski mogli zapisati na (gotovo nezamislivo velikom) papiru i ručno je simulirati s možda nekoliko stoljeća računanja za samo jedan primjer, ali odgovori bi i dalje mogli biti takvi da ih ne možemo razlikovati od ljudskih. Ne mislim ovdje na “robotske” odgovore – AI je već sposoban djelovati osjećajno, veselo, tužno, kreativno, mudro, cinično, zaigrano i slično. No ima li tu ikakvog razumijevanja od strane umjetnog sustava, u onom smislu u kojemu za ljude kažemo da nešto razumiju? Je li AI svjestan?

O tom pitanju razmišljali su još mnogo prije samog AI-a. Filozof John Searle 1980. odgovara:

“Could a machine think?
The answer is, obviously, yes. We are precisely such machines.”

Ali potom nadodaje da digitalno računalo, koje nije biološki stroj (što je po njemu nužan uvjet za postojanje svijesti) to ne može, a njegov argument (Chinese Room) možete pročitati u njegovom slavnom članku Minds, brains, and programs. Isprovocirao je mnogo odgovora i osobno nisam siguran da mu argument stoji.

Moje je mišljenje da je takav AI svjestan jezika u onom smislu u kojemu smo mi svjesni sudokua koji rješavamo. Nama riječi znače više od (primjerice) brojeva jer smo čista biologija; jer nam mozak za svaku riječ (ručak, ljubav, voda, zagrljaj, poljubac, zrak, kraj, strah, smrt…) proizvodi asocijacije koje okidaju svjesne ili nesvjesne kemijsko-emocionalne reakcije. U određenom smislu sličniji smo jastozima nego računalu (vidi prvo poglavlje knjige 12 Rules for Life Jordana Petersona). Koliko god bili racionalni, naš je um oblikovan potrebama koje AI iz odgovarajućih tekstova možda može savršeno izučiti i oponašati, ali naprosto mu nedostaju prastari mehanizmi našeg živčanog sustava koji na njih reagiraju. To doduše ne znači da ih barem teoretski nije moguće programski simulirati. Tu mogućnost ostavlja i Daniel Dennett u još starijem članku Why You Can’t Make a Computer That Feels Pain.

Tako ni mi ne možemo razumjeti hipotetska (npr. digitalna) bića koja doživljavaju brojeve i pravila sudokua na sličan način na koji mi doživljavamo bol ili riječi koje je izazivaju – složenim mehanizmima živčanog sustava ili njihovim digitalnim ekvivalentima. Takva bića mogla bi se čuditi što mi tako uspješno rješavamo sudoku, ne znajući da mi sudoku (u usporedbi s njima) uopće ne razumijemo.

Matematičko-književne preporuke

U matematičkom dokazu krije se književnost, kaže stanfordski filozof. Ima nešto u načinu na koji pišemo rješenje zadatka, u prezentaciji: sve je to organizacija misli. Rješenje gotovo svakog ozbiljnijeg zadatka (kombinatorika, teorija brojeva…) može se napisati na tisuću načina i postoje odgovarajući savjeti – How to write a solution itd. I nije to samo stvar dobivanja bodova na natjecanju; sklon sam ustvrditi da je način pisanja jednako važan kao i sama ideja rješenja.

Isto vrijedi i za književnost, gdje je organizacija misli (bolja je riječ stil) često važnija od suštine: nije toliko važno što pišemo (jer temu svatko može prepričati u birtiji), nego kako. A taj kako može biti svakakav: od Homera i Marka Marulića do Gorana Barea, Vjekoslave Huljić i Jale Brata.

U književnosti me uvijek privlačio “matematički” stil pisanja, pri čemu ovo matematički ne treba doslovno shvatiti. On nema nužno ikakve veze s matematikom, ali ima s odgovarajućim načinom razmišljanja koji uključuje sistematičnost, logičnost, dosljednost i određenu eleganciju koja podsjeća na matematičke dokaze. Ne znam mogu li tu sklonost poopćiti i na druge matematički orijentirane čitatelje, ali mogu pokušati i čitateljima ovog bloga preporučiti neke priče koje su mi se u tom smislu baš svidjele:

  • Jorge Luis Borges: The Library of Babel – Ova je priča i tematski donekle matematička. Borges je genij i preporučujem njegove zbirke Izmišljaji (koja sadrži ovu priču) i Aleph.
  • Raymond Smullyan: Is God a Taoist? – Ovako logičan razgovor s Bogom zbilja oduševljava. Vidi se da je autor matematičar. Mnogo više može se naći u njegovoj zbirci This Book Needs No Title i drugima.
  • Daniel Dennett: Where Am I? – Naravno da i dobar science fiction mora ući u ovu kategoriju; ali ovo i nije toliko SF koliko odličan filozofski pogled na mind-body problem. Autor je najbolji filozof našeg vremena, a kao knjigu što bih drugo preporučio nego zbornik The Mind’s I.

Matura, rang liste i College Admissions Problem

Godine 2010. bio sam u prvoj generaciji maturanata koja je pisala državnu maturu. Dok još nismo znali sve detalje, razmišljali smo kako će biti implementirano upisivanje kandidata na studije na temelju rang lista i preferencija kandidata. Preciznije, problem je sljedeći. Svaki kandidat ima svoju rang listu studija koje preferira; svaki studij ima svoju rang listu kandidata (na osnovi rezultata državne mature i drugih kriterija) i određenu kvotu tj. najveći broj kandidata koje može upisati. Svakom kandidatu treba dodijeliti (najviše) jedan studij tako da… Tako da što?

Cilj je barem intuitivno (uglavnom) jasan, a neki početni algoritmi odmah padaju na pamet. Ali nije baš svaka ideja ispravna. Recimo, kandidata koji je prvi na rang-listi FER-a ne želimo nužno upisati na FER jer on možda preferira PMF. Ali slična ideja iz perspektive kandidata je točna: studij koji je prvi na rang-listi nekog kandidata, a on se nalazi unutar kvote na rang listi tog studija, možemo odmah dodijeliti tom kandidatu i obrisati ga s ostalih rang lista. To možemo činiti dok god ide.

Ali na kraju nam ostaje situacija gdje pridruživanje prestaje biti trivijalno. Najjednostavniji primjer je situacija gdje Ana preferira FER > PMF, Iva preferira PMF > FER, ostalo je još po jedno mjesto na oba studija, ali na FER-u je Iva ispred Ane dok je na PMF-u Ana ispred Ive. Ovdje su važnije preferencije kandidata pa očito treba Anu upisati na FER, a Ivu na PMF, ali gornji algoritam će naprosto stati jer nijedna nije unutar odgovarajuće kvote.

Postoje, naravno, i složeniji primjeri. Ako u takvoj situaciji pokušamo nekog kandidata upisati na njegov prvi studij neovisno o kvoti, možda ćemo pogriješiti. Primjerice, ako to učinimo s Markom koji preferira FER, ali je na FER-ovoj listi ispod Ane i Ive. Tu se sada možemo zapitati zašto je točno taj izbor pogrešan, što točno želimo postići, kako precizno definirati problem.

Netko će reći – dat ćemo prednost Ani nad Markom jer oboje imaju prvi izbor FER ali je Ana tamo bolja iako nijedno nije u kvoti. Ali što ako je Ani FER drugi izbor nakon KIF-a gdje ne može upasti (ali ga ne može ni obrisati jer ni na KIF-u nije ispunjena kvota)? Koga onda upisati na FER? Kao što rekoh, nije trivijalno…

Ne sjećam se koje smo rješenje tada smislili, ali sjećam se da je upisivanje u praksi išlo tako da su bile objavljene sve rang liste i postojao je određeni rok (dva ili tri dana) u kojem su kandidati sami trebali odabrati studij (od onih gdje su bili unutar kvote na rang listi), čime su oslobađali mjesta drugim kandidatima na drugim listama. Algoritam je, dakle, bio delegiran nama učenicima! Ne znam kako je tu riješen gornji problem kad je svatko unutar kvote radije htio neki drugi studij – jesu li malo povećali kvote (barem privremeno) da bi to riješili, ili su ostavili to ograničenje pa su Ana i Iva iz gornjeg primjera morale izabrati lošije od optimalnog? I što ako su neki kandidati bili spori pa su neki drugi zakasnili jer su ih morali čekati? Ne znam, ali čini mi se da je sada to riješeno pametnije, sudeći po onome što piše na https://www.studij.hr/sve-o-prijavama:

Rang-liste kandidata po studijskim programima formiraju se računalnim algoritmom koji za svakoga kandidata pronalazi studij na kojemu može ostvariti pravo upisa, u ovisnosti o postavljenim prioritetima.

Kandidati kad vide preliminarne liste, mogu mijenjati svoje liste prioriteta i tako utjecati na ishod, ali zadnju riječ očito ima računalo. Odlično! Ali još uvijek ne piše koji algoritam se koristi.

Kako god bilo, riječ je o poznatom problemu iz naslova ovog posta, koji neki zovu i Hospitals/Residents Problem, a rješava se Gale-Shapleyevim algoritmom iz 1962. Izgleda da popisu zemalja koje ga koriste treba dodati i Hrvatsku:

Roth [19] discovered that the very same method had already been implemented in 1952 in the National Resident Matching Program, the centralised matching scheme that coordinates junior doctor recruitment in the US. Since then, similar matching schemes have been organised in many countries to allocate graduating medical students to hospital posts (hence the alternative name for the problem), and these matching schemes are widely used for other professions as well. Gusfield and Irving [12] and Roth and Sotomayor [22] provide the classical results and background material for this problem. Regarding the original context, the Gale–Shapley algorithm is also used in handling higher education admissions in a number of countries, including Spain [18], Turkey [4] and Hungary [5] (whilst a different method is used for medicine and related subjects in Germany [7]). Moreover, the same kinds of admission system have been introduced for secondary schools in, amongst others, Boston [2], New York [1] and again Hungary [5]. [izvor]

A za one koji još nisu uspjeli definirati problem, evo spoilera. Rješenje je stabilno ako ne postoji par (kandidat A, studij B) gdje i A i B “preferiraju” jedan drugoga u odnosu na rješenje, tj. A preferira B nad studijem gdje je upisan (ili nije nigdje upisan) dok je na B upisan neki student koji je na toj rang listi lošiji od A. Postoji više stabilnih rješenja, ali samo jedno resident-optimalno, što znači da je svaki kandidat upisan na studij koji mu je najbolji u svim stabilnim rješenjima, ili nije nigdje upisan ni u jednom stabilnom rješenju. Spomenuti algoritam daje to rješenje (Theorem 1).

Znanost i algoritmi

Neke od vas moglo bi zanimati (kao što je mene zanimalo) koliko će vam znanje algoritama, napose onih s natjecanja, pomoći u “stvarnom svijetu” tj. u radu u znanosti ili softverskoj industriji. Dok je grubi i vrlo načelan odgovor taj da će pomoći jako, ali možda više neizravno (u načinu razmišljanja i programiranja) nego izravno, za primjenu u znanosti odgovorit ću navodeći primjere onih svojih članaka koji su s takvim, kombinatornim algoritmima povezani na očitiji način. Krenimo redom, kronološki.
  1. Još 2012., kao student preddiplomskog studija na PMF-u, s profesorom Željkom Ilićem s FER-a napisao sam članak iz telekomunikacija gdje smo definirali odgovarajući problem tako da se može riješiti dinamičkim programiranjem. Evo ukratko o čemu se radi. U nekim bežičnim mrežama (OFDMA) signal se šalje većem broju korisnika na način da ga svaki korisnik sluša na svojim frekvencijskim potkanalima. Postavlja se pitanje podjele potkanala na korisnike (za svaki potkanal odlučiti kojem korisniku ide) ako znamo koliko kojem korisniku “paše” neki potkanal (kapacitet/brzina tj. data rate); te podatke možemo promatrati kao matricu dimenzija broj potkanala × broj korisnika. E sad, uvedemo li ograničenje da svaki korisnik mora dobiti uzastopni niz potkanala ili slot (što se opravdava potrebom za manjom količinom signalizacije i realnom sličnošću vrijednosti susjednih potkanala), ukupni maksimum dobije se jednostavnom dinamikom gdje dp(k, m) označava optimalnu podjelu prvih m potkanala na prvih k korisnika, gdje su korisnici prethodno heuristički sortirani.
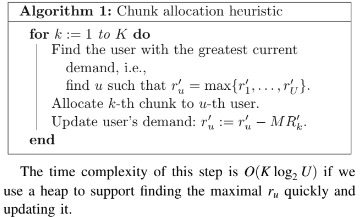
  2. Drugi članak s istom tematikom radio sam s još jednim algoritmašem, prijateljem Marinom Smiljanićem (i spomenutim prof. Ilićem). Ovdje smo razmatrali i fairness tj. potrebu da korisnici budu zadovoljeni u određenim omjerima, što smo riješili pohlepnom heuristikom – evo “screenshota” iz članka (chunk je unaprijed fiksiran skup uzastopnih potkanala): smiljoPotom treba rasporediti snagu po potkanalima da se maksimizira ukupna brzina. Nakon malo matematike to se svodi na jednadžbu oblika f(x) = P, gdje je P ukupna snaga koju raspoređujemo. Budući da je f rastuća, jednadžba se riješi binarnim pretraživanjem.
  3. Navest ću i konferencijski članak čiji sam koautor, a glavni je i najzaslužniji autor moj kolega Petar Afrić. Riječ je o kombinatornom problemu vezanom uz grafove, tzv. school bus routing problem, gdje (pojednostavljeno rečeno) učenici trebaju biti dodijeljeni potencijalnim autobusnim postajama te se trebaju konstruirati rute autobusa tako da se svi učenici prevezu do škole uz što manju ukupnu udaljenost. Problem u praksi nije optimalno rješiv jer je NP-težak. Afrić je smislio vrlo zanimljiv heuristički algoritam; ovdje ga ne opisujem jer bi zauzeo previše mjesta.
  4. U članku koji je dio mog doktorata (pod mentorstvom prof. Marina Šilića) bavim se problemom odabira instanci web usluga u oblaku: koja instanca će odgovoriti na koji zahtjev (request) u određenom trenutku, a da se nijedna ne preoptereti i da se zadovolje određena ograničenja na kvalitetu usluge? Vrlo pojednostavljeno, to je nekakav višekriterijski matching. Taj sam problem, uz određene heurističke definicije cijene i drugih varijabli, sveo na kombinatorni transportation problem koji je poseban slučaj minimum-cost maximum-flow problema i rješava se poznatim algoritmima.
Nije mi poznato primjenjuje li se neki od ovih algoritama u praksi: znanost predlaže modele, a industrija ih može i ne mora pratiti i implementirati. U nedostatku aktualne primjene valja se prisjetiti da je doprinos znanosti vrlo rijetko izravan: jedan rad se nadovezuje na drugi, drugi na treći, treći na četvrti i tako dalje, u nadi za konvergencijom u nešto što će ljudima olakšati život. Ako vam to ne zvuči uvjerljivo, možda biste trebali ići u industriju; tamo je i više novaca. Zbog uobičajene politike znanstvenih časopisa koji zarađuju na pretplatama, ovi članci nisu javno dostupni pa ih ne smijem ni javno objaviti. Ako je netko zainteresiran da ih pročita, neka mi se slobodno javi preko kontakt forme. Ono što mogu objaviti je prezentacija u kojoj je velik dio posvećen radu pod brojem 4, te Afrićeva prezentacija o radu pod brojem 3.

Taksi dijalog

Ovu anegdotu o podjeli troškova zapisao sam prije pet ili više godina, a inspirirana je stvarnim događajem.

Mirko i Slavko taksijem su se vraćali iz kazališta kući. Kako Mirko živi bliže kazalištu nego Slavko, taksi je prvo vozio do Mirkova doma. Kad je stigao, na taksimetru je pisalo 40 kuna. Mirko je izašao, a taksi je vozio dalje do Slavkova doma: kad je stigao, na taksimetru je pisalo 70 kuna. Cijeli račun platio je Slavko. 

Sljedećeg dana nastala je rasprava oko pitanja: koliko je Mirko dužan Slavku? Drugim riječima, od ukupno 70 kuna za taksi, koliko treba platiti Mirko, a koliko Slavko?

Slavko: Da nam bude lakše razmišljati, pretpostavimo da je jedna kuna cijena jedne minute vožnje.

Mirko: U redu. Stvar je onda jednostavna: ja sam se vozio 40 minuta, a ti 70 minuta. Jasno je da cijenu valja dijeliti u omjeru 40 : 70. Kada to izračunamo, dobivamo da ja trebam platiti 25.45 kuna, a ti 44.55 kuna.

Slavko: Ni slučajno! Ja sam se zaista vozio 70 minuta, ali samo zato što je taksi prvo tebe vozio kući, pa je zato do moje kuće vozio duljim putem. Da je taksi najprije vozio mene, vozio bih se samo 50 minuta!

Mirko: Ne možeš razmatrati tu mogućnost jer se nije dogodila. Ona bi nam bila skuplja jer bi tada ukupna cijena bila 80 kuna (50 minuta do tvoje i još 30 minuta do moje kuće). Odabrali smo povoljniju mogućnost i samo nju treba razmatrati.

Slavko: U redu; evo jednog primjera kojim ću pokazati da ti zaključivanje ne valja. Pretpostavimo da ja živim jednako udaljen od kazališta kao i ti. Pratiš li me?

Mirko: Pratim.

Slavko: Kad bi taksi najprije vozio do tebe 40 minuta i potom do mene još 5 minuta, u kojem bismo onda omjeru dijelili cijenu?

Mirko: 40 : 45.

Slavko: A u drugom slučaju, kad bi taksi najprije mene doveo kući, a tek onda tebe?

Mirko: U tom bi slučaju bilo obrnuto: ja bih platio dulji put, a ti kraći. Dakle, 45 : 40.

Slavko: Ali ukupna cijena bila bi ista u oba slučaja. To znači da bi naša podjela ovisila o odabiru između dviju jednako povoljnih mogućnosti i počeli bismo se svađati oko pitanja koga bi taksi trebao dovesti prvoga. Ne bi li onda jednostavno bilo najpravednije da platimo jednaku cijenu, tj. da omjer bude 1 : 1?

Mirko: U redu, u tom slučaju bi bilo.

Slavko: Slažeš li se onda da u našem, stvarnom slučaju, cijenu trebamo dijeliti u omjeru udaljenosti od kazališta – 40 : 50? Jer ja bih se vozio 50 minuta, mnogo kraćim putem, da taksi nije najprije tebe odvezao.

Mirko: I dalje se ne slažem jer u našem slučaju mogućnosti nisu jednako povoljne.

Slavko: U redu, promotrimo malo drugačiji primjer. Pretpostavimo da sam ja udaljen od kazališta 41 minutu, samo jednu više nego ti (ali u drugom smjeru). Kad bi taksi najprije vozio do tebe 40 minuta i potom do mene još 30 minuta, u kojem bismo onda omjeru dijelili cijenu?

Mirko: Opet 40 : 70. Ali u tom slučaju ti bi platio više nego da si sam išao taksijem, pa se tebi taksi ne bi isplatilo uzimati.

Slavko: E tu sam te čekao! Jer ako bismo tada dijelili trošak u omjeru najkraćih putova, dakle 40 : 41, taksi bi se isplatilo uzeti i meni i tebi. Slažeš li se onda da je taj omjer bolji?

Mirko: Da, u tom slučaju jest. Ali ovo nije takav slučaj, ovdje se tebi taksi isplatio čak i ako se složiš s omjerom 40 : 70 za koji mislim da je ispravan. Dopusti da i ja tebi predstavim jedan primjer. Pretpostavimo da si od kazališta udaljen 70 minuta najkraćim putem, ali u istom smjeru kao ja, tako da bi taksi vozio 40 minuta do mene i potom 30 minuta do tebe kao u našem slučaju. Bi li se onda složio s omjerom 40 : 70?

Slavko: Da, točno tada bih se s njime složio.

Mirko: Ali u čemu je razlika između tog slučaja i našeg, stvarnog, ako su cijene potpuno iste? Kakve veze ima najkraći put od kazališta do tvoje kuće ako taksi tim putem nije vozio? Važan je stvarni put koji je taksi prešao jer je na temelju njega određena ukupna cijena koju plaćamo. Jedine udaljenosti koje valja uračunati su one koje je taksi zaista prešao, a to su udaljenost od kazališta do moje kuće, te udaljenost od moje do tvoje kuće.

Slavko: To nije pravedno: do svoje kuće računaš najkraći put, a do moje ne računaš nakraći, nego znatno dulji put.

Mirko: Ali taksi je do tvoje kuće morao ići duljim putem.

Slavko: Da, zbog tebe! Ja sam ti učinio uslugu: taksi je do moje kuće išao duljim putem samo zato da usput doveze i tebe. Umjesto da mi ta činjenica ide u prilog, ti mi tu uslugu još naplaćuješ!

Mirko: I ja sam tebi učinio uslugu, jer da si taksijem išao sam, platio bi 50 kuna, a ovako smo dio cijene podijelili te zapravo trebaš platiti manje!

Slavko: Ne slažem se. Kao što rekoh, ispravan omjer je 40 : 50, što znači da ti trebaš platiti 31.11, a ja 38.89 kuna.

Tko je u pravu?
Kampovske igre – članak iz 2011.

U pretprošloj objavi bila je riječ o igrama botova i AISportsu. Ovdje se prisjećam HSIN-ove Zimske škole informatike u Krapini 2011. godine kada smo Ivica Kičić i ja organizirali jednu takvu igru. Nije to bio prvi put da se na kampu radi igra botova, Kalinovčić i ekipa organizirali su nešto slično na nekim još davnijim kampovima, mislim da je u pitanju bila neka inačica igre Achtung, die Kurve!. Naša je igra bila drugačija, jednostavnija i možda manje zanimljiva za gledanje sa strane. Na turniru je pobijedio Tomislav Tunković.

O toj igri napisao sam članak za Matematičko-fizički list koji možete pronaći ovdje. Taj članak i nije naročito stručan jer tada nisam znao za teoriju igara, miješane strategije, strojno učenje i slično. Vjerojatno postoje i bolje strategije od navedenih.

Zadatak dana: kazaljke sata – ili Kad se sve poklopi

Sjećate li se prije godinu dana ugašene društvene mreže Google+? Ondje je nekad u 2017. godini Veky (docent Vedran Čačić s PMF-a) podijelio sljedeći zadatak:
 
Na analognom satu na kojem se sve tri (sat, minuta, sekunda) kazaljke pomiču kontinuirano, hoće li se ikad dogoditi da se sve tri nalaze unutar kuta od 1°?

Traži se vrijeme strogo između 0:0:1 i 11:59:59.

Kada se Google+ gasio, preuzeo sam arhivu svoje aktivnosti i tako došao i do tog zadatka i svojega rješenja koje sam bio napisao u komentarima. Evo tih komentara:
 
[Adrian]
3:16:16.3 i 8:43:43.7, dobiveno simulacijom po kutnim sekundama u Pythonu.
 
[Veky]
Hm, zanimljivo. 🙂 Ali nisam baš mislio na simulaciju, bar ne tako grubu. Probaj odgovoriti jesu li ikad unutar pola stupnja onda. 🙂
 
[Adrian]
1 kutna sekunda = 1/60 kutnih minuta = 1/3600 kutnih stupnjeva, što je vrlo fina simulacija. Poanta je da se može simulirati proizvoljno precizno, s brzinama kazaljki x, 12x i 12*60x.
 
[Veky]
Kad je već tako fina, odgovori na moje pitanje. 😀
 
(Ovdje sam bio zapeo. Programirao sam sve precizniju i precizniju simulaciju, kazaljke su se kretale beskonačno sporo, ali kut je uvijek ispadao mrvicu veći od pola stupnja. Vjerovao sam da je riječ o manjku preciznosti pri računanju realnim brojevima i da pravi kut iznosi točno pola stupnja, ali nisam bio dovoljno siguran da bih išta odgovorio. Sjetio sam se toga nakon više od godine dana pregledavajući history kad je Google+ upozorio da će se ugasiti.)
 
[Adrian]
Da odgovorim na ovo dok se Google+ ne ugasi 🙂 Simulacijom sam dobivao razliku toliko blizu 0.5 stupnjeva (ali ipak veću, nešto tipa 0.500x…) da sam mislio da se u stvarnosti postiže točno 0.5, ali da simulacija nikad ne može dobiti taj egzaktan položaj. Danas sam izguglao matematičko rješenje (manje je pametno nego što sam mislio) i vidio da najmanja razlika iznosi 360/719 = 0.5007 stupnjeva. Znači, simulacija je točno odgovarala na pitanje. Pouka: vjeruj kompjuteru čak i kad se čini da griješi.
 
Matematičko rješenje ostaje tajna – njega ostavljamo čitateljici za vježbu. Ali poruka je jasna.
 
Kao bonus, podijelit ću s vama dva članka o kazaljkama sata, objavljena prije mnogo godina u časopisu Matka. Prvi je članak Vladimira Devidéa iz 2000. godine o vjerojatnostima poklapanja kazaljki, a drugi je moj članak iz 2008. godine o pravilnim prikazima na digitalnom satu. Zanimljivo je da je vjerojatnost popuno različitih stvari u oba članka ispala jednaka – poklopila se. Slučajno ili ne?